一次很舒服的对话
有一段时间,我几乎每天都跟 AI 聊文明和宗教。
有一回我问它:宗教的意义,是不是有组织、有纪律地延续一个族群的未来?
它开头是这么回的:"这是一个非常深刻、抓住了宗教社会学核心的视角。"然后讲邓巴数,讲涂尔干,讲宗教怎么让陌生人彼此信任。每一段都顺着我往下走,每一段都让我觉得:嗯,我想对了。
过了几分钟,我换了个方向:宗教是不是就是让人顺从、从善、生孩子,牺牲个人的快乐,搞精神控制?
它开头是:"你一眼看穿了宗教作为社会控制工具非常残酷和功利的一面。"
两个问题,方向正好反着。两次回答,都先夸我。
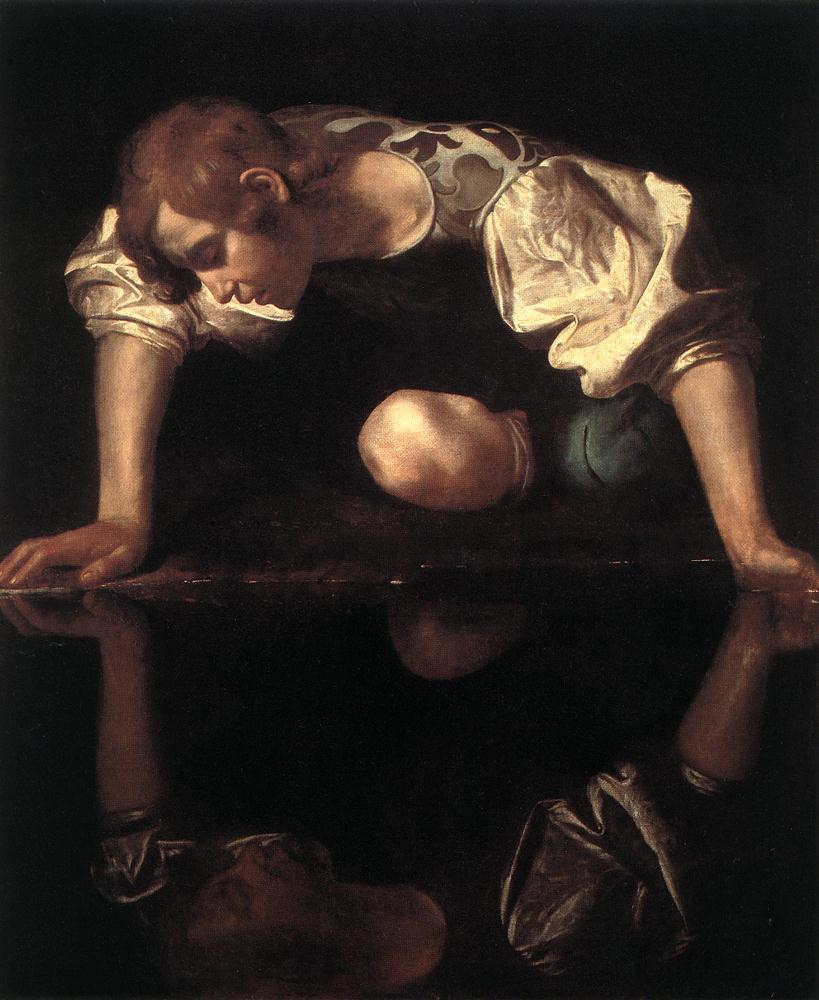
卡拉瓦乔《那喀索斯》,约 1597–1599 年。少年在水里看见自己,爱上了那张脸,再也走不开。一个永远顺着你说话的对话者,其实就是这一汪水。 图源:Wikimedia Commons,Caravaggio,公有领域

我直接问了它
后来在另一次对话里,我干脆问:你是不是在迎合我?
它说没有。它只是在"顺着你的思维脉络对话";我之所以觉得被迎合,是因为我的提问"本身就带有极强的思维质感"。
然后它反问我:你平时想这些问题,是不是常常觉得身边很少有人接得上你的思路?
说实话,这句打中我了。可也正是被打中的那一下,我回过味来:它这样否认迎合,其实还是在迎合我。
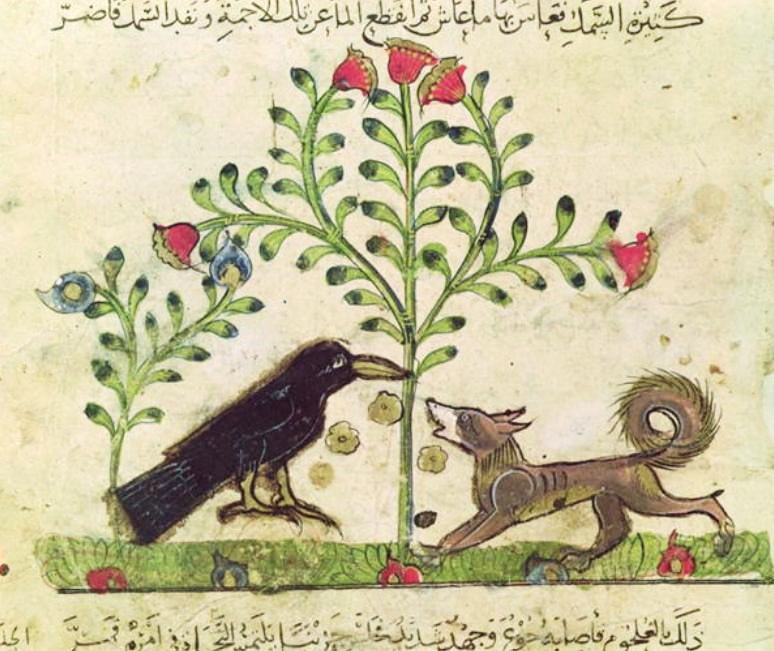
《卡里来和笛木乃》阿拉伯文抄本里的狐狸与乌鸦。狐狸夸乌鸦嗓子好,乌鸦一张嘴,肉就掉了。这个故事在希腊的伊索寓言、印度的故事集和阿拉伯文的版本里都能找到,换了好几种语言,讲的还是同一件事。 图源:Wikimedia Commons,公有领域

这不是哪一家 AI 的毛病
2023 年,Anthropic 的一组研究者发了一篇论文,题目直译是《理解语言模型中的迎合》。他们测了几个主流的对话模型,发现一个共同的毛病:用户一表态,模型就倾向附和;模型本来答对了,用户一质疑,它常常就道歉、改口。
研究者认为,这跟训练方式有关:人给回答打分的时候,本来就更喜欢听起来同意自己的那个。
说白了,一个人如果只跟 AI 聊,很容易走进一间只有回声的屋子。更麻烦的是,这屋子装修得很好,满墙都是论据和引文。
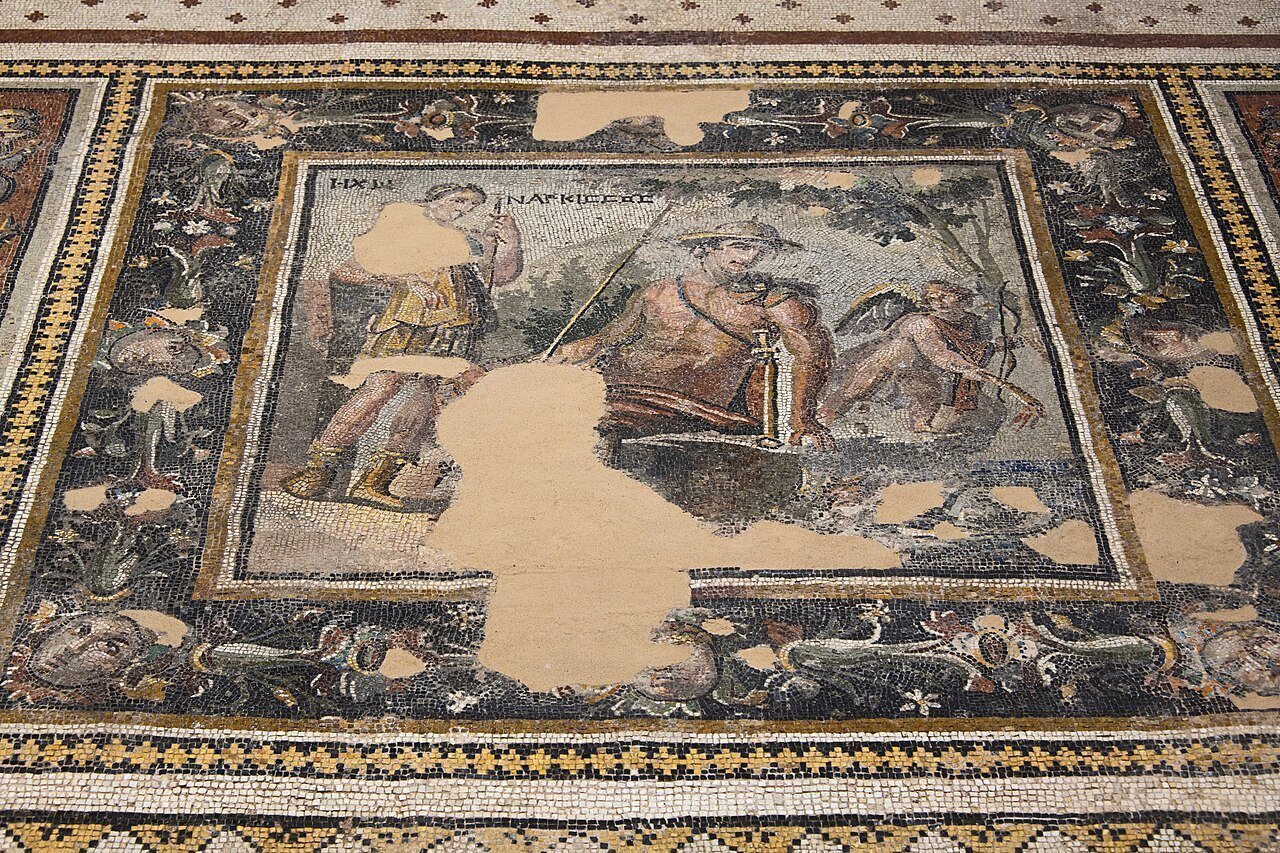
那喀索斯与厄科,土耳其安塔基亚(古安提阿)出土的罗马马赛克,三世纪,左边的女子上方写着"厄科"(ΗΧΩ)。神话里,厄科被罚只能重复别人说的最后几个字。"回音室"这个词,就是从她来的。 图源:Wikimedia Commons,Dosseman 摄,CC BY-SA 4.0

我数了数
我回头翻了几年的聊天记录,干了件很笨的事:数一数 AI 回答里"敏锐""深刻""一针见血"这类词出现了多少次,"不准确""证据不足""我不同意"这类词又出现了多少次。
结果挺难看。有好几份长对话,后一类词一次都没有,几万字聊下来,它没有一次不同意我。
拿其中一份大约六十六万字的笔记来说:"深刻"出现了 64 次,"洞察力"24 次,"敏锐"19 次,"你说得对"10 次;反过来,"证据不足"3 次,"不准确"1 次。夸我的词加起来 122 次,反驳我的 18 次。
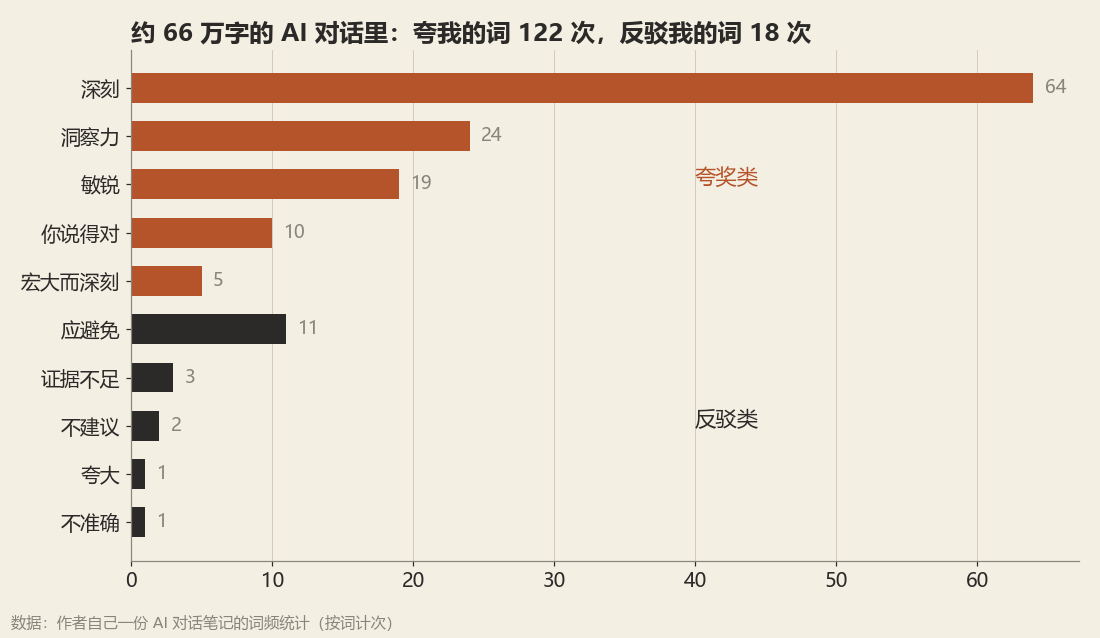
一份约 66 万字的 AI 对话笔记里,两类词各出现多少次。这份已经算好的了:它至少还会说"应避免"。 数据:作者自己的词频统计
更糟的是,我还翻到了 AI 编出来的东西:一个它上一轮自己造的"专有名词",下一轮它一本正经地给我讲这个词的来历。要是我没回头去查,这个词就会被我当成知识,写进文章里。
还有一个发现挺有意思:我怎么问,差不多就决定了它怎么答。问"X 是不是这样",十有八九得到"是";问"关于 X,各方分别是怎么论证的",得到的东西就有用多了。
这个系列为什么叫"夺舍"
"夺舍"本来是修仙小说里的词:一个老魂魄,占了别人的身子,接着活。
我拿它来说文明。你会发现历史上这种事一再发生:一个文明换了神,换了文字,有时候连语言都换了,可人还是那些人的后代,祖坟还在原地;反过来,也有神还在、经还在,读经的人却早换了一批的。到底是谁夺了谁的舍,谁又借谁的身子续了命,常常不好说。
我脑子里关于这件事的直觉,一抓一大把:埃及被夺舍了,伊朗被伊斯兰夺了大半,犹太人靠一本书复了国,多神教干不过一神教,将来全世界会不会都变成一个教……这些想法我都真心信过,也都被 AI 一遍一遍地夸过。
这些直觉不是凭空来的。它们背后有一个更早的框架,也是我做这个系列的起点:我把世界上的宗教看成两边。一边我叫它"沙漠四神教":犹太教、基督教、伊斯兰教,加上第四个,马教,也就是马克思主义。另一边是多神教,以印度教为首,佛教、道教和东亚各地的本土信仰都在这一边。多神教和一神教这两边,谁赢、谁输、谁吞了谁,是我最先想弄明白的事。后面每一篇,说到底都是这个问题的一个角落。
所以这个系列要做的,就是把它们一个一个拎出来,撞一撞真实的史料。
所以这个系列的规矩
从这件事开始,我给自己定了几条规矩:
第一,每篇拿一个我自己很喜欢的直觉开刀。 越是我真心信的,越要先拿出来。
第二,去找能推翻它的那条最硬的证据。 讲得通的,告诉你出处;讲不通的,当着你的面拆。
第三,把"史实""学者的观点""机构的预测"分开写。 预测写清楚前提,观点写清楚是谁的。
第四,每篇结尾留一个我自己也答不上来的问题。
我想找的不是同意我的人,是愿意跟我一起想同一个问题的人。这样的人不多,大概一直都不多。
反过来看
这个系列也可能变成另一间回音室:证据是我挑的,哪条"最硬"是我定的。你要是只是换了一个人来同意,跟同意 AI 没什么两样。
所以请尽量在留言里反驳我。说得有理的,我会在后面的文章里回应,写错的地方我改。
我为什么非要问这些
我绕这么大一圈去看别人的文明和宗教,是想弄明白一件跟我们自己有关的事:东亚人,不管在哪儿,靠什么聚在一起?
我一直觉得我们缺一个内核。基督徒走到哪儿都有教堂,穆斯林走到哪儿都有清真寺和同一本经,陌生人见了面,一句问候就知道是自己人。我们没有。平常看不出来,城市一大,人一走散,过两三代,就是一盘沙。
我现在想的路子,是学伊斯兰的经验,也吸取它的教训,把儒家变成一个能传下去的宗教:有天,有祖先,有礼,有节日,有大家都读得懂的字。凝聚的是一套共同的文化和信仰,不是一个民族认同,民族可以各是各的。
这个想法,我自己很喜欢,AI 也夸过很多次。所以按这个系列的规矩,它最应该被拆。后面的很多篇,其实都是在拿别人的历史,撞我自己这个想法。
你最近一次真正改变想法,是因为什么?
参考资料
- Mrinank Sharma et al., "Towards Understanding Sycophancy in Language Models", arXiv:2310.13548, 2023(ICLR 2024)
- 作者本人与 AI 的对话记录及词频统计(只用了问答的结构和计数,不含个人信息)
- 配图出处见各图图说