二十几条评论
有一次,我在网上刷到一个问题,问康熙和洪承畴是什么关系。我当时顺手把评论区截了图,一共二十几条。
最近回头翻出来,我才发现,这二十几条评论几乎完整地记下了一个说法是怎么长出来的。
最开始有人只是疑惑:洪承畴那样一个人,怎么会被人劝几句就投降了?下面有人接:可能是孝庄安排的。再下面有人说:那顺治也是被做了局。又有人问,鳌拜是不是知道些什么。接着有人说,康熙那么喜欢数学,说不定就是汉人的基因。再往后,有人翻出了洪承畴父亲的名字,最后有人总结了一句,意思是这叫"三代还宗"。
从一个疑问,到一整套身世,前后就二十几条评论。
我反复看了几遍,最大的感受是:这里面没有一个人在撒谎。每个人都只是接了一句话,而且接得都挺顺。可没有一句是证据。每一句都只是"能接得上的下一句"。
一百年前,顾颉刚说中国古史是"层累地造成的","时代愈后,传说中的中心人物愈放愈大"。他说的层累,用了一两千年。这个评论区,用了一个下午。
第一道工序:推荐
这个说法后来在 2025 年 11 月突然火了。我抓了网上跟洪承畴有关的 9 个话题的精华区,一共 670 条回答,其中 515 条是那一个月发的。
网上讨论这件事最早的那个问题,底下回答有上千个。按默认排序看前 35 条,赞同数从两千多到一万五,没有一条是反驳的。
反驳其实有,写得也不差,最好的一篇讲 DNA 研究,赞同上了一千。但写得好的那几篇都不在那个问题底下,得另外去搜才搜得到。在我抓的 670 条里,带反驳用语的只有 31 条,不到百分之五。
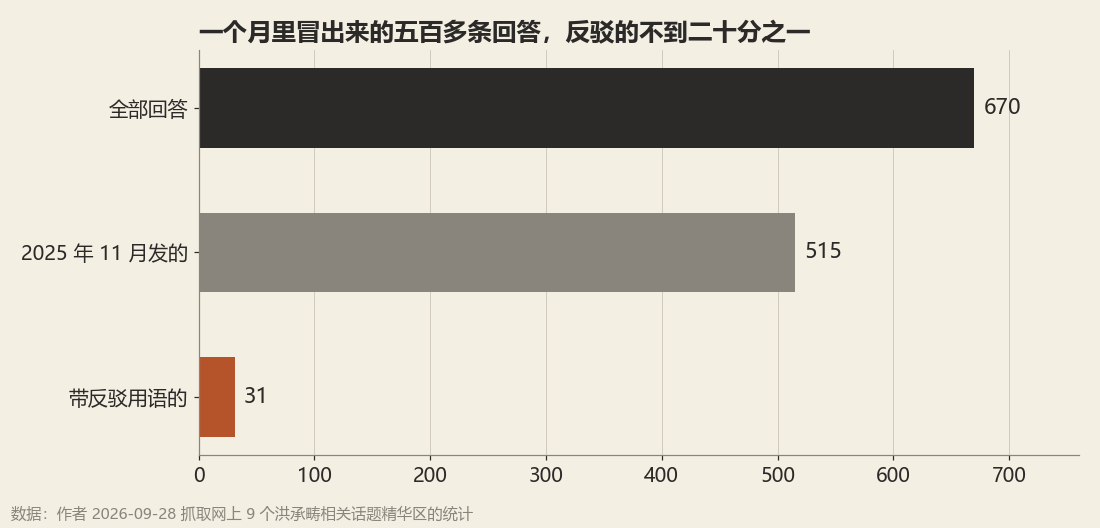
网上 9 个洪承畴相关话题的精华区:670 条回答,515 条发在 2025 年 11 月那一个月,带反驳用语的 31 条。 数据:作者自己的抓取统计
平台是按什么排序的,我不知道。但结果是,一个人如果只是顺着刷,他看到的,几乎全是同一个方向的东西。
第二道工序:我
然后是我自己。
那几年,我存了一千八百多张截图。截图这个动作本身就是一次筛选:我觉得有道理、有意思、想留着的,才会截。
后来这些截图被转成了文字,差不多八十六万字。我在里面搜过一些词,比如"偷换概念""以讹传讹""幸存者偏差""因果倒置",这些通常是反驳别人时才会用的词。
结果是,八十六万字里,这些词一次都没有出现。
我并没有刻意不收反驳,只是反驳读起来不舒服,手指就不会去按那个截图键。平台已经替我筛过一遍,我又替自己筛了一遍。
第三道工序:AI
再后来,我拿着这些截图里的想法去问 AI,让它帮我梳理、补充、找论据。
它做得很好。一条条零散的评论,被它整理成了有来龙去脉、有"疑点"、有推理的一整套说法,还常常顺带夸我一句"很敏锐"。
AI 为什么总是顺着人说,我在另一个系列《夺舍》的第一篇里专门写过,这里不重复。我只想说一点:到了这一步,那二十几条评论里"能接得上的下一句",已经变成了一篇看起来像论文的东西。
最后一道:写进了我的素材
我在写一部架空历史剧,前期收了很多材料。洪清假说和癸酉本《红楼梦》,都曾经出现在我的素材里,而且位置还不低。
后来回头查,我才看清这条线:
平台推荐给我 → 我截下认同的 → AI 替我整理成套 → 进了我的剧本素材。
四道工序,每一道都往同一个方向推,没有一道把相反的东西放进来。所以我在素材里找不到反方,并不是因为反方不存在,是它在第一道工序就已经被筛掉了。
为什么每一道都往同一边推
回头想,这条线上其实没有坏人。
平台想让人多看一会儿,它就推大家停得最久的内容。我想读让自己舒服的东西,就截认同的。AI 被训练得让人满意,就顺着我说。每一方都只做了一件很自然的事。
可这些很自然的事串在一起,方向一致,力量就叠起来了。一个评论区里的随口一句,走完这条线,就成了我素材库里的"疑点"。
我觉得这可能是伪史在今天最常见的长法。它不需要有人刻意造假,只需要每一道工序都挑自己喜欢的那一边。
反过来看
第一,反驳也在这条线上跑。我在《依归》那篇里写过,反驳洪清假说的人也出了不少错:把弘昼写成康熙的儿子,把"康熙出生时洪承畴还活着"说成时间矛盾。所以这条线放大的不只是伪史,也包括不太严谨的辟谣。
第二,我的样本本身有偏。我抓的是话题精华区,不是全部回答;我的截图,也只是我一个人的收藏。这些数字能说明"一个人顺着刷会看到什么",不能说明"大家普遍怎么想"。
第三,门其实一直开着。那篇讲 DNA 的反驳赞同上了一千,说明有不少人愿意去读。后来在另一个 AI 那里,也有一次对话把整条说法一条条拆开了,给的都是能查的证据。再后来我发现,只要把"这是不是真的"换成"正反两方各自怎么论证",得到的回答就会很不一样。这个办法一直在我手上,只是之前没去用。
你的收藏夹里,有多少条是你不同意、却还是留下来的?
参考资料
- 作者对网上 9 个洪承畴相关话题精华区的抓取统计(2026-09-28)
- 作者自己的网上截图收藏(2024–2026,约 1800 张,转成文字约 86 万字)的词频统计
- 顾颉刚《与钱玄同先生论古史书》,1923 年;收入《古史辨》第一册,1926
- 《夺舍》系列:《我问 AI 两个相反的问题,它两次都说我深刻》
- 《依归》系列:《1653 年闰六月十八日,洪承畴在北京》
- 配图出处见各图图说